Liquid AI udostępniło 24 września otwarty model pomocniczy, który dzięki dekodowaniu spekulatywnemu przyspiesza generowanie odpowiedzi w małym modelu wizyjno-językowym LFM2.5-VL-3B. Nowy „drafter” o nazwie DSpark ma około 280 mln parametrów, a na Macu z układem M5 Max przyspiesza dekodowanie od 2,3 do ponad 3 razy. Jakość odpowiedzi ma pozostać bez zmian, bo ostatnie słowo nadal należy do modelu głównego.
Jak działa dekodowanie spekulatywne w DSpark
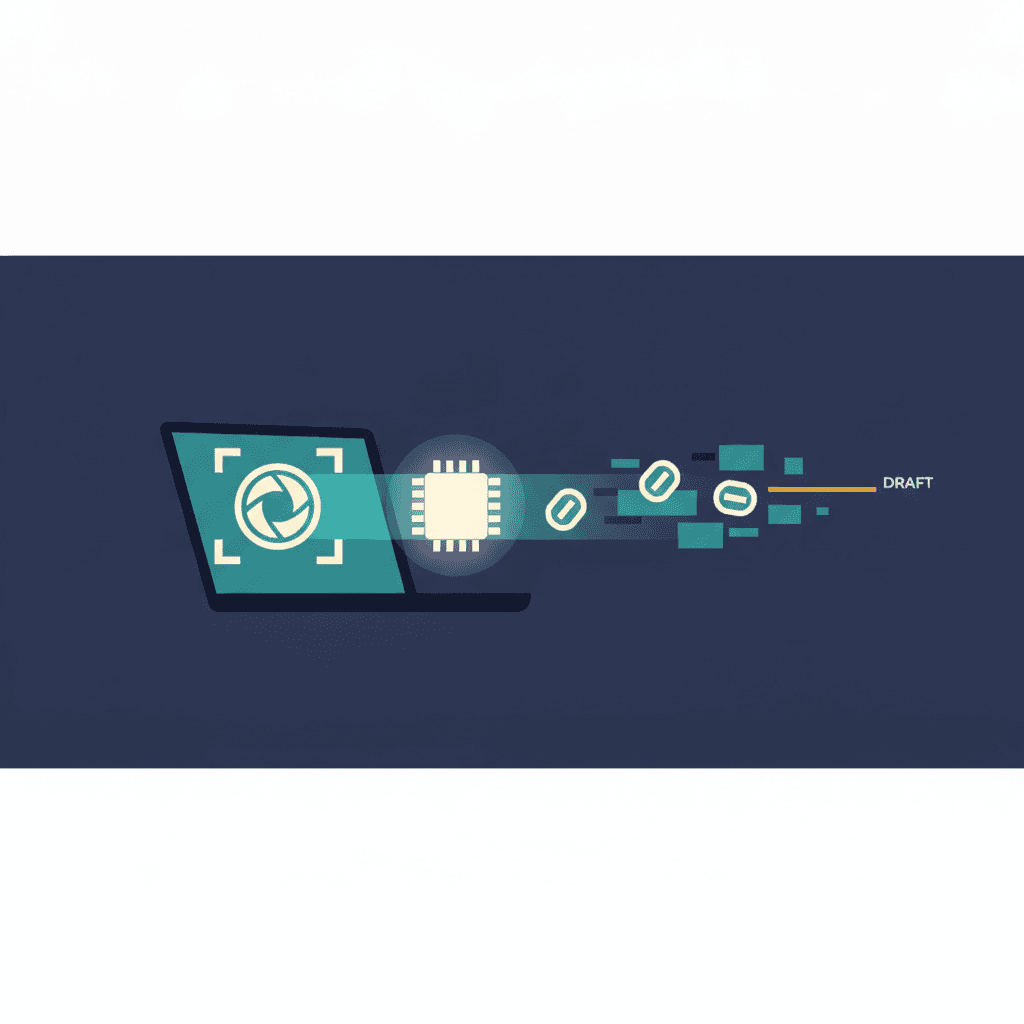
Idea jest prosta. Mały model szkicowy proponuje kilka kolejnych tokenów naraz, a duży model tylko je weryfikuje. Jeśli szkic jest trafny, oszczędzamy wiele kroków obliczeń. Jeśli nie, model główny poprawia wynik, więc odpowiedź jest taka sama jak bez przyspieszenia.
DSpark to czterowarstwowy drafter oparty wyłącznie na mechanizmie uwagi. Korzysta ze stanów ukrytych pobieranych z wybranych warstw modelu głównego i szkicuje bloki po 8–9 tokenów. Fragmenty obrazu i tekst trafiają do wspólnej przestrzeni reprezentacji, dzięki czemu ten sam drafter obsługuje obie modalności. Kosztem jest wzrost liczby parametrów o około 8,9% względem modelu 3B.
Liczby z testów
Liquid AI sprawdziło rozwiązanie na sześciu typach zadań wizyjnych: ogólnych pytaniach o obraz, odczycie tekstu ze zdjęć, opisywaniu obrazów, pytaniach o wykresy, złożonym rozumowaniu i rozmowie wieloetapowej. Deklarowane przyspieszenia wyglądają tak:
- MLX na Apple M5 Max: dekodowanie 2,30–3,13 razy szybciej, cały proces 1,56–2,62 razy szybciej.
- llama.cpp na Apple M3 Ultra: dekodowanie 1,57–2,14 razy, cały proces 1,30–1,77 razy.
- GPU NVIDIA H100: dekodowanie 2,0–2,66 razy, cały proces 1,64–2,27 razy.
Autorzy otwarcie wskazują ograniczenie. Technika przyspiesza tylko generowanie tokenów, a nie kodowanie obrazu ani przetwarzanie promptu. Przy zadaniach, w których dominuje analiza dużego zdjęcia, a odpowiedź jest krótka, zysk będzie mniejszy. To także wyniki producenta, a nie niezależny pomiar.
Co to znaczy dla polskich firm
Małe modele wizyjne uruchamiane lokalnie to realna opcja tam, gdzie dane nie powinny opuszczać firmy. Przykłady to odczyt faktur i dokumentów, kontrola jakości na zdjęciach z produkcji albo analiza wykresów w raportach. Model 3B działający na stacji roboczej oznacza przetwarzanie bez wysyłania obrazów do chmury, co upraszcza ocenę zgodności z RODO. Szybsze dekodowanie to krótszy czas oczekiwania użytkownika i więcej dokumentów obsłużonych na tym samym sprzęcie.
Warto pamiętać o dwóch rzeczach. Po pierwsze, wagi są otwarte, ale udostępnione na własnej licencji Liquid AI oznaczonej jako lfm1.0, więc przed wdrożeniem komercyjnym trzeba przeczytać jej warunki. Po drugie, przyspieszenie należy zmierzyć na własnych danych, bo zależy od proporcji między analizą obrazu a długością odpowiedzi. Wydanie jest oznaczone jako eksperymentalne.
Dostępność
Drafter jest dostępny na Hugging Face w dwóch wersjach: LiquidAI/LFM2.5-VL-3B-DSpark (Safetensors) oraz jako wariant GGUF. Obsługę dodano do llama.cpp, MLX-VLM i SGLang. Do działania potrzebny jest model główny LFM2.5-VL-3B.
Źródło: Hugging Face Blog: Accelerating vision-language models with LFM2.5-VL-DSpark (EN), 24 września 2026. Parametry i licencja: karta modelu LiquidAI/LFM2.5-VL-3B-DSpark (EN).